
ลองใช้ Headroom บีบ context ก่อนส่งเข้า Claude Code
รีวิว Headroom ตัวบีบ context ก่อนส่งถึง LLM ตั้งแต่วิธีติดตั้ง ตัวเลขจริงที่วัดได้จากเครื่องตัวเอง ไปจนถึงข้อดีข้อเสียและเรื่องที่ควรรู้ก่อนเอาไปใช้จริง
Introduction
ใครใช้ Claude Code หรือ Codex เป็นหลัก น่าจะเคยเจอว่า token ไหลเร็วกว่าที่คิด Agent อ่านไฟล์ ยิง grep ดึง log แล้วทั้งหมดก็เข้าไปอยู่ใน context รอบถัดไปก็ส่งต่อไปอีก
ช่วงนี้ผมเลยลอง Headroom ซึ่งเป็น proxy ที่คั่นระหว่าง agent กับ provider แล้วช่วยลดขนาด context ก่อนส่งออก ตอนเขียนบทความนี้ repo มีดาวเจ็ดหมื่นกว่า ทั้งที่เพิ่งสร้างเมื่อเดือนมกราคมปีนี้
ตัวเลขในบทความนี้มาจากการใช้งานจริงหนึ่งวันบนเครื่องผมเอง ใช้ Headroom v0.37.0 คู่กับ Claude Code ส่วน output ที่แปะไว้ก็ก๊อปมาจาก terminal โดยตรง มีตัดบางบรรทัดที่ไม่เกี่ยวออกให้อ่านง่ายขึ้น แต่ไม่ได้แก้ตัวเลข
ผลที่ได้ต่างจากที่ผมคิดไว้ตอนแรกพอสมควร
Headroom คืออะไร
ถ้าอธิบายแบบสั้น ๆ Headroom คือชั้นที่ช่วยลดขนาด context โดยรันอยู่บนเครื่องเราเอง ข้อมูลที่ผ่านมันมีทั้ง tool output, log, ไฟล์, RAG chunk และประวัติแชท
ข้างในมีตัวจัดการหลายแบบตามชนิดข้อมูล เช่น SmartCrusher สำหรับ JSON ก้อนใหญ่, CodeCompressor สำหรับโค้ดที่อ่าน AST ได้ 11 ภาษา ได้แก่ Python, JS/TS, Go, Rust, Java, C/C++, C#, PHP และ Perl ส่วนข้อความทั่วไปใช้โมเดลชื่อ kompress-v2-base โดยมี ContentRouter คอยเลือกว่าจะส่งข้อมูลไปให้ตัวไหนจัดการ
CodeCompressor มีเงื่อนไขค่อนข้างเข้ม เอกสารระบุไว้ตรง ๆ ว่าแทบไม่ทำงานในสถานการณ์จริง เพราะมันจะไม่แตะโค้ดที่เพิ่งคุยกันหรือกำลังวิเคราะห์อยู่ เพื่อลดโอกาสที่ข้อมูลสำคัญจะถูกบีบจนเพี้ยน
จากที่ผมใช้ทั้งวัน มันทำงานแค่ 3 ครั้ง
อีกอย่างที่ผมชอบคือข้อมูลเดิมย้อนกลับได้ ของต้นฉบับถูก cache ไว้ในเครื่อง และโมเดลสามารถเรียก headroom_retrieve เพื่อขอข้อมูลเต็มกลับมาได้ ถ้าข้อมูลที่ถูกบีบไม่พอใช้งาน
Headroom ใช้ได้ 4 แบบ คือเรียกเป็น library, รันเป็น proxy, ใช้ wrap agent หรือเสียบเป็น MCP server ผมเลือกแบบ wrap เพราะตั้งค่าง่ายสุด
วิธีติดตั้ง
CLI มีเฉพาะบน PyPI ส่วน headroom-ai บน npm เป็น TypeScript SDK ไม่มีคำสั่ง headroom ให้ใช้
ต้องใช้ Python 3.10 ขึ้นไป
uv tool install --python 3.13 "headroom-ai[all]"
ผมแนะนำให้ล็อก Python เป็น 3.13 ไปเลย เพราะตัวคำนวณค่าใช้จ่ายของ Headroom ใช้ LiteLLM ซึ่งยังลงบน Python 3.14 ไม่ได้ ถ้าใช้ 3.14 จำนวน token ยังนับได้ตามปกติ แต่ตัวเลขเงินใน dashboard จะค้างที่ $0.00
เช็กเวอร์ชันก่อน
headroom --version
headroom, version 0.37.0
จากนั้นสั่ง wrap Claude Code ได้เลย
headroom wrap claude
คำสั่งนี้จะเปิด proxy ที่ port 8787 แล้วรัน Claude Code โดยตั้ง ANTHROPIC_BASE_URL ให้ชี้เข้าหา proxy พร้อมตั้ง ENABLE_TOOL_SEARCH ให้ด้วย
ถ้าต้องการถอนก็ใช้
headroom unwrap claude
ก่อนเริ่มใช้จริงควรรัน doctor สักรอบ
headroom doctor
Headroom Doctor v0.37.0 · port 8787

┃ check       ┃ status ┃ summary                                     ┃
│ proxy       │ ✓ pass │ running at http://127.0.0.1:8787 (up 3m)    │
│ version     │ ✓ pass │ proxy matches installed v0.37.0             │
│ claude      │ ✓ pass │ routed via ...                              │
│ wrap_marker │ ✓ pass │ live wrap session (pid 84723)               │
│ shell env   │ ✓ pass │ routed via ANTHROPIC_BASE_URL               │
│ budget      │ ⚠ warn │ no budget configured — spend is unlimited   │
ถ้า budget ขึ้นเตือนแบบนี้ เราสามารถตั้งเพดานรายวันผ่าน environment variable ได้
HEADROOM_BUDGET=10 headroom wrap claude
ส่วน --budget ใช้กับคำสั่ง headroom proxy ถ้ารัน proxy เอง อย่าเปิดซ้อนกับตัวที่ wrap เปิดไว้ เพราะจะชนกันที่ port 8787
ตัวเลขหลังใช้หนึ่งวัน
ดูแบบเร็ว ๆ ได้จาก
headroom dashboard
ซึ่งจะเปิด dashboard ที่ 127.0.0.1:8787/dashboard
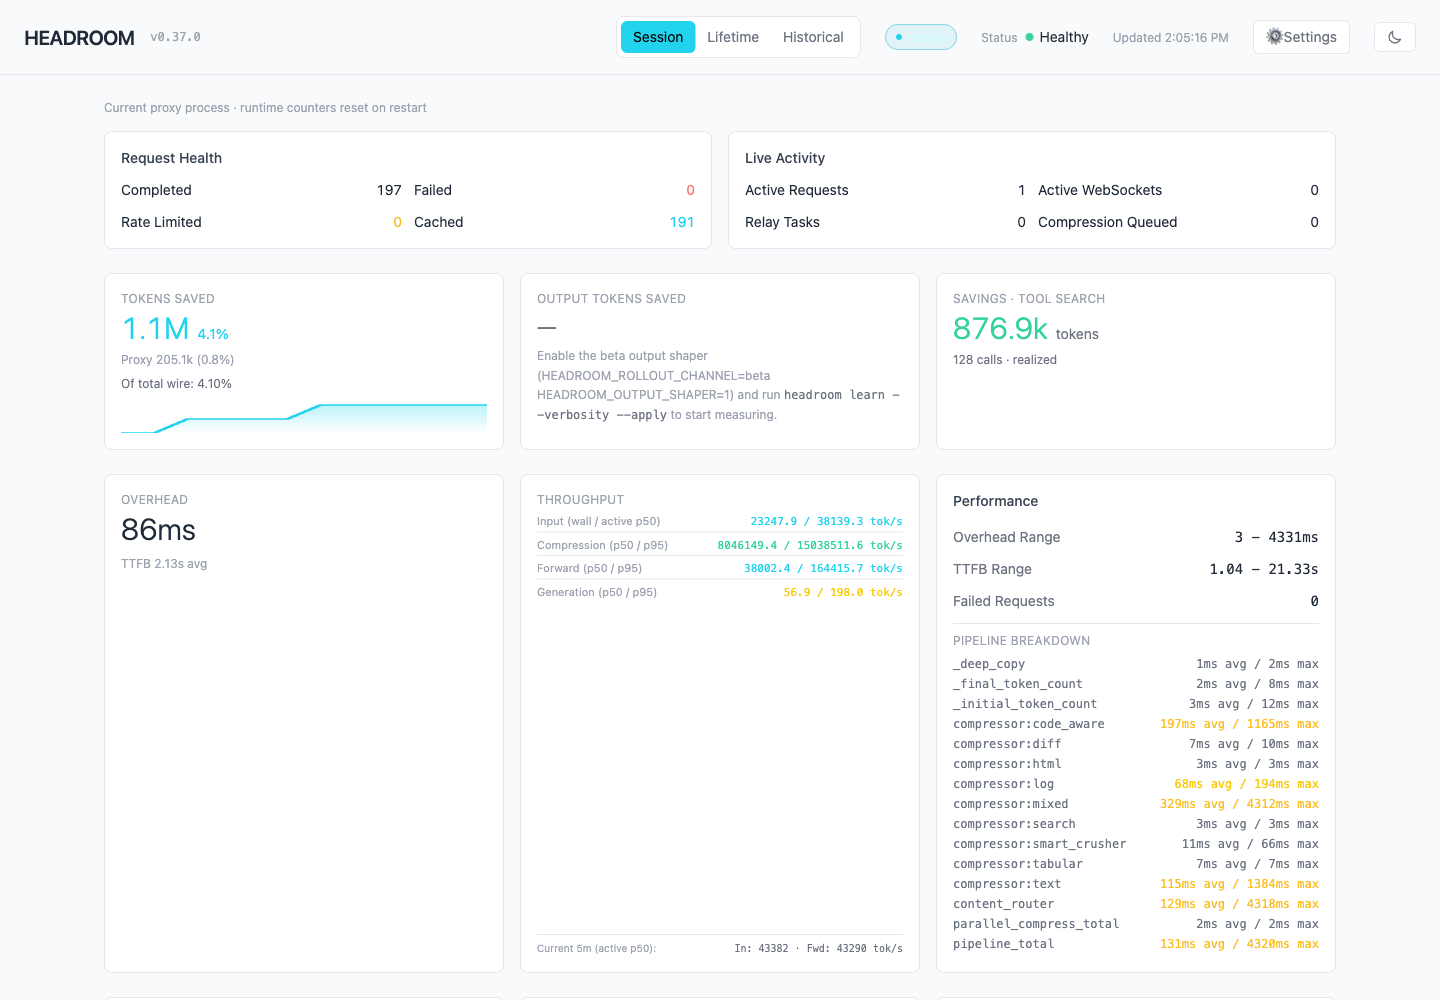
ภาพนี้ผมถ่ายทีหลัง ตัวเลขเลยขยับจากค่าที่จะยกมาด้านล่างเล็กน้อย แต่สังเกตช่อง SAVINGS · TOOL SEARCH ไว้ เพราะส่วนนี้แยกจาก TOKENS SAVED
ถ้าอยากดูตัวเลขดิบ ดึงจาก /stats ได้ตรง ๆ
curl -s 127.0.0.1:8787/stats | jq .summary.compression
{
  "requests_compressed": 129,
  "avg_compression_pct": 1.7,
  "best_compression_pct": 11.8,
  "best_detail": "15,316 → 13,505 tokens",
  "total_tokens_removed": 130497,
  "total_tokens_before": 10992312,
  "tool_schema_tokens_saved": 484226,
  "total_tokens_saved_all_layers": 614723
}
ตัวเลขที่น่าสนใจคือ compression ลดไป 130,497 token แต่ tool_schema_tokens_saved ลดไปถึง 484,226 token
สองอย่างนี้เป็นคนละกลไกกัน ตัวหลังมาจากการไม่ส่ง schema ของ tool ทั้งหมดไปหาโมเดลทุก request แล้วโหลดเฉพาะตัวที่ต้องใช้
ในงานของผม เกือบ 80% ของ token ที่ประหยัดได้มาจาก tool search มากกว่า compression
น่าเสียดายที่ /stats ยังไม่ตีมูลค่าส่วนนี้เป็นเงิน
curl -s 127.0.0.1:8787/stats | jq -c '.savings.by_source'
[{ "source": "tool_search", "realized": true, "events": 79, "tokens": 484226, "usd": 0.0 }]
ประหยัดไปกว่า 480,000 token แต่ usd ยังเป็น 0.0
ถ้าดูเฉพาะตัวเลขเงินบน dashboard จึงอาจทำให้เข้าใจว่าประหยัดได้น้อยกว่าความเป็นจริง เพราะมันนับเงินจากฝั่ง compression แต่ไม่ได้รวม token ที่ลดลงจาก tool schema
แล้วทำไม compression ของผมถึงต่ำ?
README อธิบายไว้ค่อนข้างตรง ถ้า input เป็นข้อความล้วนหรือข้อมูลค่อนข้างแน่นอยู่แล้ว มันจะบีบได้ไม่มาก ส่วน benchmark 21–57% ที่เขาโชว์เป็นงานอย่าง code search, incident investigation, สำรวจ codebase หรือ triage issue ซึ่งมี tool output ก้อนใหญ่ให้ลดได้เยอะกว่า
วันที่ผมทดสอบ ผมนั่งเขียน Markdown ภาษาไทยเป็นหลัก เลยแทบไม่มีข้อมูลแบบนั้น
อีกอย่างคือ avg_compression_pct ที่ขึ้น 1.7% เป็นค่าเฉลี่ยต่อ request ถ้าเอา token ที่ลดได้ทั้งหมดหารด้วย token ก่อนบีบทั้งหมด จะได้ประมาณ 1.2%
ส่วน cache_savings_usd ใน dashboard ขึ้นตัวเลขค่อนข้างสูง แต่ตรงนี้ไม่ใช่เงินที่ Headroom ประหยัดให้ทั้งหมด
ใน /stats มีคำอธิบายว่า
Cost discount from provider prefix caching. Headroom's CacheAligner improves
hit rates; baseline caching is provider-native.
baseline caching is provider-native หมายความว่า prompt cache เป็นความสามารถของ Anthropic API ที่ Claude Code ใช้อยู่แล้ว
สิ่งที่ Headroom ทำคือพยายามไม่ทำให้ cache เดิมเสีย และช่วยจัดส่วนที่เพิ่มเข้ามาใหม่ให้เข้ากับ cache มากขึ้น
หลังใช้จริงแล้วชอบอะไรบ้าง
ติดตั้งง่าย ใช้ headroom wrap claude ครั้งเดียวแล้วทำงานต่อได้เลย ถ้าจะถอนก็มี unwrap
ส่วนที่เห็นผลชัดที่สุดในงานของผมคือ tool schema ลดไปกว่า 400,000 token ในวันเดียว แม้ dashboard จะยังไม่แสดงเป็นมูลค่าเงินก็ตาม
ข้อมูลที่ถูกบีบยังเรียกกลับมาได้ผ่าน headroom_retrieve
เรื่อง latency ก็ไม่ได้รู้สึกชัด จาก /stats ของผม overhead เฉลี่ยอยู่ราว 100 ms ต่อ request ขณะที่เวลารอโมเดลตอบอยู่ในหลักสิบวินาที
README ระบุ overhead ไว้ที่ 0.21 ms แต่ตัวเลขนั้นเป็น path ของ JSON ส่วนข้อความธรรมดาจะวิ่งเข้าโมเดล ML ซึ่งช้ากว่า จากที่ผมเจอ request ที่หนักที่สุดใช้เวลาประมาณ 4 วินาที
เครื่องมือสำหรับดูสถานะก็มีค่อนข้างครบ ทั้ง doctor, dashboard และ /stats
จุดที่ผมติดตอนใช้งาน
Tool output อาจถูกบีบจนข้อมูลหาย
อันนี้เป็นเรื่องที่ผมกังวลที่สุด
ตอนเขียนบทความนี้ ผมให้ agent ใช้ grep หาคำใน README บน terminal ผมเห็น output ครบตามปกติ แต่ข้อมูลที่ส่งไปถึงโมเดลเหลือแค่นี้
328:you
330:preserved. vscode-claude`
Agent เกือบสรุปว่าไม่เจอข้อมูลที่ต้องการ
พอเรียก headroom_retrieve เอาของเต็มกลับมา กลายเป็น
328:you use the Claude Code panel; the dashboard or proxy log printed at startup
330:preserved. `Ctrl+C` stops the proxy; `headroom unwrap vscode-claude` restores the
ข้อความถูกตัดกลางประโยค
ปัญหาคือคนที่นั่งดู terminal ไม่เห็นความผิดปกติ เพราะ output ฝั่งเรายังครบ คนที่เห็นข้อมูลไม่ครบคือโมเดล
สัญญาณหนึ่งที่ช่วยบอกได้คือข้อความท้าย output
[276 words compressed to 174 (from 6 source lines). Retrieve more: hash=24aa7b12]
ของต้นฉบับไม่ได้หาย สามารถเรียกคืนได้ แต่ agent ต้องรู้ก่อนว่าข้อมูลที่ได้รับไม่ครบ
ถ้าเป็นงานที่ทุกบรรทัดมีผลต่อการตัดสินใจ เช่นวิเคราะห์ log หรือ audit เรื่อง security ผมคิดว่าควรระวังตรงนี้เป็นพิเศษ
wrap จะติดตั้ง Serena ให้ด้วย
README ระบุว่าเมื่อใช้ wrap Headroom จะติดตั้ง Serena ซึ่งเป็นเครื่องมือช่วย navigate code แบบเข้าใจ symbol แล้วลงทะเบียนไว้ที่ user scope ใน ~/.claude.json
นั่นหมายความว่าโปรเจกต์อื่นก็จะเห็น Serena ตัวนี้จนกว่าจะ unwrap
ถ้ามี Serena อยู่ก่อนแล้ว config เดิมยังอยู่ จากที่ผมตรวจของตัวเองไม่ได้ถูกเขียนทับ
ถ้าไม่ต้องการใช้ Serena สามารถสั่ง
--code-memory none
ตอน wrap ได้
มีการแก้ config และสร้างไฟล์ในโปรเจกต์
ถึงเราจะไม่ต้องแก้ config เอง แต่ wrap มีการแก้หลายอย่างให้เบื้องหลัง
ของผมมันเพิ่ม MCP server ชื่อ headroom เข้าไปใน ~/.claude.json ที่ user scope และสร้างไฟล์ในโปรเจกต์ เช่น
.claude/.headroom_wrap_marker.json
.headroom_wrap_owners.json
.headroom/
ไฟล์พวกนี้โผล่ใน git status เป็น untracked
ควรเพิ่มลง .gitignore ไว้ก่อน
.headroom/
.claude/.headroom_wrap_*
Telemetry เปิดเป็นค่าเริ่มต้น
ค่า default ของ telemetry คือเปิด
เอกสารระบุว่าส่งข้อมูลอย่างอัตราการบีบ ชื่อ provider/model, OS และสถาปัตยกรรม โดยไม่ส่ง prompt, code หรือ path
ถ้าไม่ต้องการส่ง ปิดได้ด้วย
HEADROOM_BEACON=off
หรือ
DO_NOT_TRACK=1
หรือใช้ --offline
เครื่องผมตั้ง DO_NOT_TRACK ไว้อยู่แล้ว เลยไม่ได้ส่งออกตั้งแต่แรก
ฟีเจอร์บางอย่างของ Claude Code ใช้ไม่ได้
เมื่อ ANTHROPIC_BASE_URL ชี้ไปที่ proxy Claude Code จะปิด /remote-control
ส่วน context 1M token ต้องสั่งเองด้วย
headroom wrap claude --1m
Claude Desktop ยังไม่รองรับ เพราะตัวแอปจะเขียนทับ base URL
ออกเวอร์ชันถี่มาก
ตอนที่ผมเช็ก มี 198 เวอร์ชันบน PyPI ในเวลาประมาณ 7 เดือนครึ่ง
ข้อดีคือแก้บั๊กเร็ว แต่ก็หมายความว่า behavior และรายละเอียดต่าง ๆ เปลี่ยนค่อนข้างไว
สรุป
ก่อนลอง ผมคิดว่าเหตุผลหลักของการใช้ Headroom คือ compression
หลังใช้หนึ่งวัน กลับกลายเป็นว่าฝั่ง compression ลด token ในงานของผมได้ไม่มาก แต่ tool search ช่วยลดไปกว่า 400K token
เรื่องที่ทำให้ผมลังเลมากกว่าตัวเลขการประหยัดคือ tool output ที่อาจถูกบีบจนข้อมูลไม่ครบ
ข้อมูลต้นฉบับยังเรียกกลับมาได้ แต่ agent ต้องรู้ก่อนว่ามีข้อมูลบางส่วนหายไป ซึ่งเป็นจุดที่ต้องระวัง เพราะคนที่นั่งดู terminal ยังเห็น output เต็มตามปกติ
ถ้างานเป็น API response ใหญ่ ๆ, JSON, code search หรือ log ยาว ๆ Headroom น่าจะมีของให้บีบเยอะกว่างานที่ผมทดสอบ
ส่วนงานเขียนหรือแก้ไฟล์ทีละไฟล์แบบที่ผมทำวันนั้น compression ช่วยค่อนข้างน้อย
ตอนนี้ผมยังเปิดใช้อยู่ เพราะอยากเก็บตัวเลขเพิ่มอีกหน่อย แต่ถ้าเป็นงานที่ข้อมูลทุกบรรทัดสำคัญ ผมคงไม่เชื่อ output ที่ถูกบีบโดยไม่ตรวจซ้ำ
ถ้าจะลองใช้ แนะนำให้ดูด้วยว่า wrap แก้อะไรบนเครื่องบ้าง และเพิ่มไฟล์ที่ Headroom สร้างลง .gitignore ไว้ก่อน