
AI-native SDLC คืออะไร? เมื่อใช้ AI เขียน Code แล้ว ต้องปรับ Workflow ตรงไหนบ้าง
สรุปแนวคิด AI-native SDLC จาก Anthropic พร้อมตัวอย่างการปรับ Workflow ในทีม ตั้งแต่กำหนดงาน เขียน Code ทดสอบ ไปจนถึง Review และนำขึ้น Production
สมมติว่าเราสั่งให้ AI เพิ่มฟีเจอร์ดาวน์โหลดใบแจ้งหนี้ ผ่านไปสักพักก็ได้ทั้ง API และปุ่มดาวน์โหลด ลองกดดูแล้วไฟล์ออกมาถูกต้อง ดูเหมือนงานใกล้เสร็จแล้ว
แต่พอส่ง Review กลับมีคำถามตามมา ผู้ใช้ดาวน์โหลดเอกสารของใครได้บ้าง? ถ้าเปลี่ยน ID ใน Request จะเห็นเอกสารของบัญชีอื่นไหม? ใบแจ้งหนี้ที่ยกเลิกแล้วควรดาวน์โหลดได้หรือเปล่า?
คำถามเหล่านี้ต้องได้คำตอบก่อนส่งงานอยู่ดี ต่อให้เขียน Code เร็วขึ้นแค่ไหนก็ตาม
The AI-native SDLC playbook ของ Anthropic มองปัญหานี้ในระดับกระบวนการ ตั้งแต่รับโจทย์จนถึงดูแลระบบหลัง Deploy ผมสรุปแนวคิดหลักไว้ แล้วลองต่อยอดด้วยฟีเจอร์ดาวน์โหลดใบแจ้งหนี้ให้เห็นว่าทีมพัฒนาปรับ Workflow ได้ตรงไหนบ้าง
AI-native SDLC คืออะไร?
SDLC หรือ Software Development Lifecycle คือกระบวนการพัฒนาซอฟต์แวร์ ตั้งแต่วางแผน ออกแบบ พัฒนา ทดสอบ Deploy และดูแลระบบ
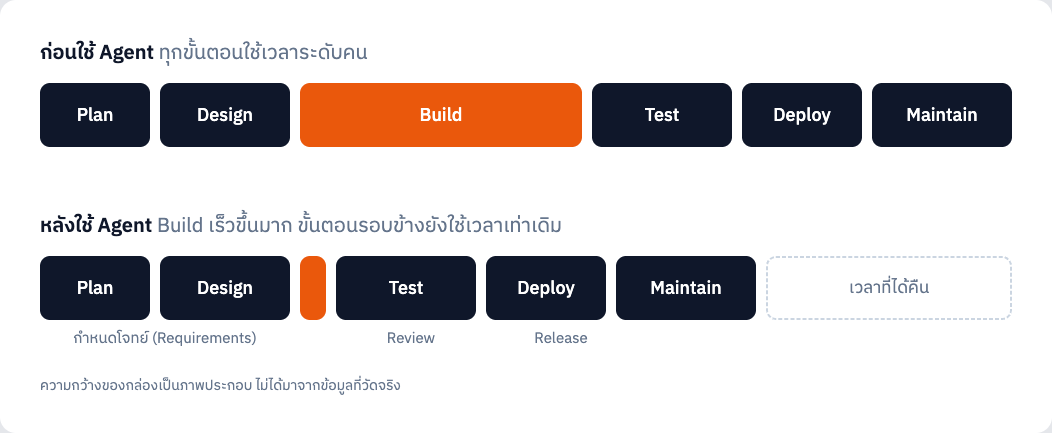
AI-native SDLC ใน Playbook คือการใช้ AI ช่วยตลอดกระบวนการ พร้อมปรับวิธีส่งต่องานและตรวจสอบผลลัพธ์ เมื่อขั้นตอนเขียน Code เร็วขึ้น งานอาจไปติดที่ Requirements, Review หรือการอนุมัติ จึงต้องมองขั้นตอนเหล่านี้ด้วย
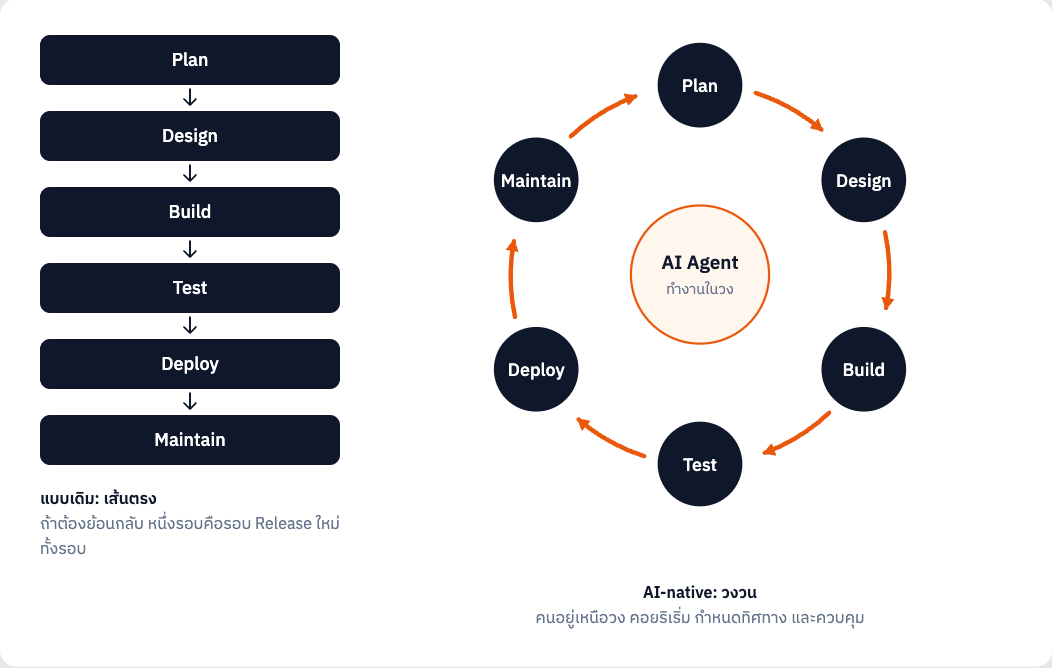
ต้นฉบับเสนอให้แต่ละช่วงทิ้งผลลัพธ์ที่ขั้นตอนถัดไปหยิบไปใช้ต่อได้ เช่น intent.md, spec.md และ plan.md พร้อมเก็บประวัติไว้ตรวจย้อนหลัง ส่วนการตัดสินใจที่ต้องใช้วิจารณญาณยังเป็นหน้าที่ของคน Skills เป็นแค่คำแนะนำ กฎที่ต้องบังคับจริงควรมีระบบตรวจหรือ Approval Gate รองรับ
เริ่มจากโจทย์ที่ตรวจรับได้
กลับมาที่ฟีเจอร์ดาวน์โหลดใบแจ้งหนี้ ถ้าโจทย์มีแค่ "เพิ่มปุ่ม Download Invoice" คนทำงานต้องเติมรายละเอียดที่หายไปเองหลายเรื่อง AI ก็เจอปัญหาเดียวกัน
ก่อนเริ่มเขียน Code เราควรตอบให้ได้อย่างน้อยว่า:
- ใครเป็นคนใช้ฟีเจอร์นี้?
- ผู้ใช้เข้าถึงใบแจ้งหนี้ชุดไหนได้บ้าง?
- เอกสารแต่ละสถานะมีเงื่อนไขต่างกันหรือไม่?
- จะตรวจอย่างไรว่างานเสร็จและทำงานถูกต้อง?
ตัวอย่างโจทย์ที่ชัดขึ้นอาจเป็นแบบนี้:
# ฟีเจอร์ดาวน์โหลดใบแจ้งหนี้

## เป้าหมาย
ให้ลูกค้าดาวน์โหลดใบแจ้งหนี้จากหน้าประวัติการชำระเงินได้

## ขอบเขต
- ผู้ใช้ต้องเข้าสู่ระบบ
- ดาวน์โหลดได้เฉพาะใบแจ้งหนี้ของบัญชีที่ตนมีสิทธิ์เข้าถึง
- รองรับเฉพาะใบแจ้งหนี้ที่ออกแล้ว
- ใช้รูปแบบ PDF เดิมของระบบ

## สิ่งที่ยังต้องตัดสินใจ
- ใบแจ้งหนี้ที่ยกเลิกแล้วควรดาวน์โหลดได้หรือไม่?
- บัญชีที่มีสมาชิกหลายคน ใช้สิทธิ์ดาวน์โหลดแบบใด?

## เกณฑ์ตรวจรับเบื้องต้น
- ผู้ใช้ที่มีสิทธิ์ดาวน์โหลดเอกสารได้
- ผู้ใช้ที่ไม่มีสิทธิ์เข้าถึงเนื้อหาเอกสารไม่ได้
- ระบบจัดการกรณีไม่พบเอกสารได้ตามรูปแบบ Error ที่ตกลงกัน
เขียนข้อที่ยังไม่มีคำตอบไว้ตรง ๆ ถ้าข้อไหนมีผลต่อสิทธิ์เข้าถึงข้อมูล ควรตกลงให้ชัดก่อนพัฒนาส่วนนั้น ถ้าปล่อยให้ AI เลือกเอง เราอาจได้ระบบที่ทำงานครบตาม Code แต่ผิดจากความต้องการของธุรกิจ
ทีมที่ใช้ Issue Tracker อยู่แล้วใส่รายละเอียดเหล่านี้ใน Ticket ได้เลย ที่ต้องตกลงกันคือทีมจะยึดข้อมูลจากที่ไหน และเมื่อแก้ Requirements ต้องอัปเดตตรงไหน เพื่อไม่ให้คนทำกับคน Review อ่านคนละเวอร์ชัน
ให้ AI สำรวจระบบเดิมก่อนเสนอวิธีแก้
แม้กำหนดโจทย์ชัดแล้ว ใน Codebase ก็ยังมีรายละเอียดที่ต้องตรวจ เช่น ระบบตรวจสิทธิ์เดิมอยู่ตรงไหน มีบริการสร้าง PDF อยู่แล้วหรือยัง และ API อื่นจัดการ Error อย่างไร
ถ้าสั่งให้สร้าง Endpoint ทันที เราอาจได้โค้ดใหม่ที่ทำหน้าที่ซ้ำกับของเดิม หรือใช้เงื่อนไขตรวจสิทธิ์คนละแบบกับส่วนอื่นของระบบ
ผมจะเริ่มด้วย Prompt แบบนี้:
อ่าน Issue และสำรวจ Codebase ก่อน ยังไม่ต้องแก้ไฟล์

ช่วยหาว่า:
- ระบบตรวจสิทธิ์เข้าถึงใบแจ้งหนี้อยู่ตรงไหน
- มีส่วนสร้างหรือดาวน์โหลด PDF อยู่แล้วหรือไม่
- API ที่ใกล้เคียงกันจัดการ Error อย่างไร
- มี Tests ส่วนไหนที่นำมาใช้เป็นตัวอย่างได้

จากนั้นเสนอแผนแก้ไข พร้อมระบุไฟล์ที่เกี่ยวข้อง
ข้อสงสัยที่ยังต้องถาม และกรณีทดสอบที่ควรเพิ่ม
ตอนตรวจคำตอบ ให้ดูว่า AI อ้างถึง Code ที่มีอยู่จริงหรือไม่ และแผนใช้กลไกเดิมของระบบได้มากแค่ไหน ถ้าตอบแค่ว่า "จะเพิ่ม Authentication และ Authorization" โดยไม่บอกว่าจะตรวจสิทธิ์ผ่านส่วนไหน ก็ยังต้องถามต่อ
การตรวจแผนตั้งแต่ตรงนี้ทำให้ทีมตกลงวิธีทำงานได้ก่อนจะมี Diff ก้อนใหญ่ให้ Review
เตรียมบริบทของโปรเจกต์ให้ตรงกับงาน
ข้อมูลบางอย่างใช้ซ้ำแทบทุกงาน เช่น คำสั่งรัน Tests โครงสร้างโปรเจกต์ หรือข้อจำกัดของระบบเดิม ทีมควรเก็บไว้ในที่ที่ผู้ร่วมงานและเครื่องมือเข้าถึงได้สะดวก
สำหรับฟีเจอร์ตัวอย่าง บริบทที่มีประโยชน์อาจเป็น:
## การพัฒนาและทดสอบ

- รัน Backend Tests ด้วยคำสั่งที่ระบุใน README
- Endpoint ใหม่ต้องใช้ Middleware ตรวจสิทธิ์ของระบบเดิม
- การเข้าถึงใบแจ้งหนี้ต้องผ่าน Billing Access Service
- ห้ามใส่เนื้อหาเอกสารหรือข้อมูลการชำระเงินลงใน Logs
- หากเปลี่ยน API Contract ต้องอัปเดตเอกสารที่เกี่ยวข้อง
อีกเรื่องที่ต้องระวังคือคำแนะนำที่หมดอายุ ถ้าเอกสารยังบอกให้ใช้ Service ที่เลิกใช้ไปแล้ว AI ก็อาจสร้างงานใหม่บนแนวทางเก่า เจ้าของระบบจึงควรแก้ข้อมูลส่วนนี้ทุกครั้งที่เปลี่ยนวิธีพัฒนา เอกสารกับ Code จะได้ไม่แยกทางกันไปเรื่อย ๆ
ทดสอบทั้งกรณีที่ควรทำได้และควรทำไม่ได้
กดดาวน์โหลดแล้วได้ PDF บอกได้แค่ว่ามีเส้นทางหนึ่งทำงานสำเร็จ เรายังต้องตรวจว่าระบบปฏิเสธการเข้าถึงที่ไม่ถูกต้องด้วย
สำหรับตัวอย่างนี้ ผมจะกำหนดกรณีทดสอบไว้ประมาณนี้:
| กรณีทดสอบ | สิ่งที่ต้องตรวจ |
|---|---|
| ผู้ใช้ดาวน์โหลดใบแจ้งหนี้ที่ตนมีสิทธิ์ | ได้เอกสารที่ถูกต้อง |
| ผู้ใช้เปลี่ยน ID เป็นใบแจ้งหนี้ของบัญชีอื่น | ไม่ได้รับเนื้อหาเอกสาร |
| เรียกดาวน์โหลดโดยไม่เข้าสู่ระบบ | ระบบปฏิเสธตาม Authentication Policy |
| เรียก ID ที่ไม่มีอยู่ | ได้ Error ตาม API Contract โดยไม่มีรายละเอียดภายในหลุดออกมา |
| บริการสร้าง PDF ล้มเหลว | ผู้ใช้ได้รับข้อความที่เหมาะสม และมีข้อมูลให้ทีมตรวจสอบปัญหา |
ผลลัพธ์ที่คาดหวังต้องมาจาก Requirements ที่ตกลงกัน เช่น จะตอบ 403 หรือ 404 ในกรณีไม่มีสิทธิ์ ให้กำหนดตามนโยบายของระบบ
ทำให้ PR บอกได้ว่าตรวจอะไรมาแล้ว
เมื่อส่ง Review คนตรวจควรเห็นทั้งสิ่งที่เปลี่ยนและหลักฐานการทดสอบ โดยไม่ต้องย้อนอ่านบทสนทนาที่ใช้สั่ง AI ทั้งหมด
ตัวอย่างรายละเอียดที่ควรมีใน PR:
## สิ่งที่เปลี่ยน
เพิ่มการดาวน์โหลดใบแจ้งหนี้จากหน้าประวัติการชำระเงิน

## การตรวจสิทธิ์
ใช้กลไกตรวจสิทธิ์เดิมของระบบ
พร้อมระบุตำแหน่ง Code ที่เกี่ยวข้องให้ Reviewer ตรวจต่อได้

## การทดสอบ
ระบุคำสั่งที่รันและผลที่ได้จริง
รวมถึงกรณีเข้าถึงเอกสารของบัญชีอื่น

## ข้อจำกัด
ระบุส่วนที่ยังไม่ได้ทดสอบ พร้อมเหตุผล

## ประเด็นที่ต้องการให้ Review
เงื่อนไขการเข้าถึงเอกสารและความสอดคล้องกับ API เดิม
ข้อความอย่าง "ทดสอบครบแล้ว" ควรมีรายละเอียดรองรับ ถ้ารัน Integration Tests ไม่ได้เพราะไม่มี Environment ก็ให้เขียนว่ายังไม่ได้รัน คน Review จะได้ประเมินงานจากข้อมูลที่ตรงกับความจริง
ส่วนการนำขึ้น Production ควรกำหนดด้วยว่าใครอนุมัติ ใช้ขั้นตอนใด และถ้าพบปัญหาจะย้อนกลับอย่างไร งานที่เปลี่ยน Schema หรือกระทบข้อมูลเดิมต้องระวังเป็นพิเศษ เพราะย้อนกลับด้วยการ Deploy Code เก่าอย่างเดียวอาจไม่พอ
เอาแนวคิด Artifact ไปใช้เป็น Workflow ในองค์กรอย่างไร?
ใน Playbook ทุกช่วงของงานจบด้วยการเขียน Artifact ลง Version Control ชุด Commit จึงเป็นประวัติว่าใครขออะไร Agent ทำอะไรออกมา และใครอนุมัติ ส่วนเรื่องที่ว่าองค์กรควรตั้งระบบอย่างไร ผมสรุปจากสิ่งที่ Playbook ระบุไว้ แล้วเรียงเป็นขั้นตอนที่ทีมลองตามได้
Playbook กำหนดคนตรวจของแต่ละ Artifact ไว้ดังนี้:
| Artifact | ใครตรวจหรือรับผิดชอบ |
|---|---|
intent.md | Product Owner ตรวจและแก้ฉบับที่ Agent เขียน ก่อน Commit |
spec.md | Product Owner ตรวจ แต่ไม่ต้องเขียนเอง |
plan.md | Engineer แก้แผนก่อนเริ่มเขียน Code |
REVIEW.md (นโยบาย Review) | Tech Lead เป็นคนเขียน |
| Skills | เจ้าของนโยบายตรวจการแก้ไขเหมือนตรวจ Code |
CLAUDE.md | ทั้งทีมช่วยกันดูแล |
ขั้นตอนที่ผมจะลอง:
เลือกที่เก็บและเจ้าของ
สำหรับผลิตภัณฑ์เดียว Playbook เสนอโฟลเดอร์ intent/ ใน Repo ของผลิตภัณฑ์ ถ้า Intent ครอบคลุมหลาย Repo ค่อยแยก Repo เฉพาะ ถ้ามีระบบเก่าที่เก็บข้อมูลอยู่แล้ว ให้ระบุว่าที่ไหนเป็นต้นทางที่เชื่อถือได้ ที่อื่นเก็บสำเนาหรือลิงก์กลับมา
ตกลงแม่แบบ intent.md
ให้ทั้งทีมใช้แม่แบบเดียวกัน เริ่มทำด้วยมือก่อน เมื่อขั้นตอนนิ่งแล้วจึงทำเป็น Slash Command ระดับองค์กร
แยกคำแนะนำออกจากกฎที่ต้องบังคับ
Playbook ระบุว่า Skill เป็นเพียงคำแนะนำ กฎที่ต้องเป็นจริงทุกครั้งต้องมีกลไกที่ตรวจแบบแน่นอนอยู่ข้างหลัง เช่น Hook, CI หรือ Approval Gate ในตัวอย่างใบแจ้งหนี้ กฎอย่าง "PR ที่แตะ Endpoint ดาวน์โหลดต้องมี Test กรณีข้ามบัญชี" ควรเป็น Check ใน CI ไม่ควรเขียนไว้ใน Skill อย่างเดียว
ให้คนอนุมัติที่ด่านขึ้น Production
ตาม Playbook Agent ทำงานได้จนถึงด่านนี้ แต่ผ่านด่านเองไม่ได้ การอนุมัติมาจากคนผ่าน Branch Protection โดยดูผล Review ประกอบ
เลือกงานเล็กหนึ่งงานแล้ววัดผล
ตัวชี้วัดที่ Playbook เสนอและเข้ากับเรื่องนี้ เช่น เวลาจากบทสนทนาแรกถึง intent.md ที่ Commit แล้ว สัดส่วนงานที่ Merge ได้ตั้งแต่รอบ Implementation แรก และเวลา Review ต่อ PR
intent.md ยาวจนคนเขียนไม่อยากกรอก ทีมจะข้ามขั้นตอนนี้ แม่แบบหนึ่งหน้าที่มีปัญหา ผลลัพธ์ที่ต้องการ ข้อจำกัด และคำถามที่ยังเปิดอยู่ พอใช้เริ่มต้นได้แล้วตัวอย่างไฟล์ของฟีเจอร์ดาวน์โหลดใบแจ้งหนี้
intent/
  invoice-download/
    intent.md
    spec.md
    plan.md
REVIEW.md
intent.md บอกว่าทำไปเพื่ออะไร ไม่ลงรายละเอียดว่าทำอย่างไร:
# Intent: ดาวน์โหลดใบแจ้งหนี้

สถานะ: อนุมัติแล้ว
เจ้าของ: Product Owner (Billing)

## ปัญหา
ลูกค้าดูประวัติการชำระเงินได้ แต่ดาวน์โหลดใบแจ้งหนี้เองไม่ได้
ต้องติดต่อทีมสนับสนุน

## ผลลัพธ์ที่ต้องการ
ลูกค้าดาวน์โหลดใบแจ้งหนี้ของบัญชีตัวเองจากหน้าประวัติการชำระเงินได้ด้วยตัวเอง

## ผู้ใช้
- ลูกค้าที่เข้าสู่ระบบ
- สมาชิกของบัญชี ตามสิทธิ์ที่กำหนดใน spec.md

## ข้อจำกัด
- ใช้รูปแบบ PDF เดิมของระบบ
- ห้ามให้ใครเห็นเอกสารของบัญชีอื่น
- ห้ามใส่เนื้อหาเอกสารหรือข้อมูลการชำระเงินลงใน Logs

## นอกขอบเขต
- ส่งใบแจ้งหนี้ทางอีเมล
- ดาวน์โหลดหลายใบพร้อมกัน

## คำถามที่ยังเปิดอยู่
| คำถาม | คนตัดสินใจ | สถานะ |
|---|---|---|
| ใบแจ้งหนี้ที่ยกเลิกแล้วดาวน์โหลดได้หรือไม่ | Product Owner | ตัดสินใจแล้ว ดู spec.md |
| บัญชีที่มีสมาชิกหลายคนใช้สิทธิ์แบบใด | Product Owner | ตัดสินใจแล้ว ดู spec.md |
spec.md เปลี่ยน Intent เป็นข้อกำหนดที่ตรวจได้ Agent เป็นคนร่าง Product Owner เป็นคนตรวจ:
# Spec: ดาวน์โหลดใบแจ้งหนี้

อ้างอิง: intent.md
สถานะ: Product Owner ตรวจแล้ว

## ข้อกำหนด
1. Endpoint ดาวน์โหลดต้องผ่าน Middleware ตรวจสิทธิ์ของระบบเดิม
2. ผู้ใช้ดาวน์โหลดได้เฉพาะใบแจ้งหนี้ของบัญชีที่ตนเป็นสมาชิก
3. ใบแจ้งหนี้สถานะ "ออกแล้ว" ดาวน์โหลดได้
4. ใบแจ้งหนี้สถานะ "ยกเลิก" ดาวน์โหลดไม่ได้
5. สมาชิกทุกคนของบัญชีดาวน์โหลดได้
6. กรณีไม่มีสิทธิ์ ตอบ 404 เหมือนไม่พบเอกสาร เพื่อไม่บอกว่ามีเอกสารนี้อยู่

## สถานการณ์ตรวจรับ
| # | เงื่อนไข | ผลที่ต้องได้ |
|---|---|---|
| 1 | สมาชิกขอใบแจ้งหนี้ของบัญชีตัวเอง สถานะออกแล้ว | 200 และได้ PDF ที่ถูกต้อง |
| 2 | เปลี่ยน ID เป็นใบแจ้งหนี้ของบัญชีอื่น | 404 ไม่มีเนื้อหาเอกสาร |
| 3 | ไม่ได้เข้าสู่ระบบ | 401 |
| 4 | ID ไม่มีอยู่ | 404 รูปแบบเดียวกับข้อ 2 |
| 5 | ใบแจ้งหนี้สถานะยกเลิก | 404 รูปแบบเดียวกับข้อ 2 |
| 6 | บริการสร้าง PDF ล้มเหลว | Error ตามรูปแบบของระบบ และ Log ID เอกสารกับสาเหตุ โดยไม่ Log เนื้อหา |
plan.md เป็นแผนที่ Agent เสนอหลังสำรวจ Codebase และ Engineer แก้ก่อนเริ่มเขียน Code:
# Plan: ดาวน์โหลดใบแจ้งหนี้

อ้างอิง: spec.md
สถานะ: Engineer ตรวจแล้ว

## สิ่งที่สำรวจเจอ
- ตรวจสิทธิ์เข้าถึงใบแจ้งหนี้ผ่าน Billing Access Service ใช้ซ้ำได้
- มีบริการสร้าง PDF ของระบบอยู่แล้ว ใช้ซ้ำได้
- รูปแบบ Error ดูจาก Endpoint ประวัติการชำระเงิน

## ขั้นตอน
1. เขียน Test กรณีข้ามบัญชี ไม่ได้เข้าสู่ระบบ และสถานะยกเลิกก่อน ต้องล้มเหลวตอนนี้
2. เพิ่ม Endpoint ดาวน์โหลด ผ่าน Middleware เดิม และเรียก Billing Access Service
3. เรียกบริการสร้าง PDF เดิม
4. เพิ่มปุ่มดาวน์โหลดในหน้าประวัติการชำระเงิน
5. อัปเดตเอกสาร API Contract

## ไม่แตะ
- Schema ฐานข้อมูล
- บริการสร้าง PDF

## ความเสี่ยงและวิธีย้อนกลับ
ไม่มีการเปลี่ยน Schema ย้อนกลับได้ด้วยการ Deploy เวอร์ชันก่อนหน้า
REVIEW.md เป็นนโยบาย Review ที่ Tech Lead เขียน ใช้กับทุก PR ในโปรเจกต์ ตัวอย่างนี้ย่อเฉพาะข้อที่เกี่ยวกับเอกสาร:
# นโยบาย Review

PR ที่แตะ Endpoint ดาวน์โหลดเอกสารต้องตรวจว่า:
- มี Test กรณีเข้าถึงเอกสารของบัญชีอื่น และผลตรงกับ spec.md
- Endpoint ผ่าน Middleware ตรวจสิทธิ์เดิม ไม่มีเส้นทางเลี่ยง
- Logs ไม่มีเนื้อหาเอกสารหรือข้อมูลการชำระเงิน
- PR ระบุส่วนที่ยังไม่ได้ทดสอบ พร้อมเหตุผล
- ถ้ามีการเปลี่ยน Schema ต้องมีแผนย้อนกลับ
ควร Commit แต่ละไฟล์แยกตามขั้นหลังคนตรวจอนุมัติ เมื่อย้อนอ่าน git log จะเห็นว่าใครอนุมัติอะไรเมื่อไร ตรงกับแนวคิดประวัติการตัดสินใจที่ Playbook อธิบายไว้
OpenSpec ช่วยเรื่องนี้ได้แค่ไหน?
OpenSpec เป็น Framework สำหรับเขียนและจัดการ Specification ให้ทีมกับ Coding Agent ทำงานตามข้อตกลงเดียวกัน รองรับ Claude Code, Codex, Cursor, GitHub Copilot, Gemini CLI และ OpenCode เป็น Open Source ภายใต้ MIT License ติดตั้งได้ด้วย npm install -g @fission-ai/openspec@latest
Workflow ของ OpenSpec เรียงเป็นคำสั่งดังนี้ ผมลองจับคู่กับหัวข้อในบทความนี้ให้ดู:
| คำสั่ง | ทำอะไร | ใกล้เคียงกับ |
|---|---|---|
/opsx:explore | สำรวจปัญหาและ Codebase | ให้ AI สำรวจระบบเดิมก่อนเสนอวิธีแก้ |
/opsx:propose | สร้าง proposal.md, specs/, design.md, tasks.md | เริ่มจากโจทย์ที่ตรวจรับได้ |
/opsx:apply | ลงมือทำตาม Tasks | ขั้นเขียน Code |
/opsx:verify | ตรวจว่า Implementation ตรงกับ Spec | หลักฐานที่ใส่ใน PR |
/opsx:archive | เก็บ Change ที่เสร็จแล้ว | เก็บประวัติไว้ตรวจย้อนหลัง |
ถ้าทีมอยากทำตามแนวคิดนี้โดยไม่ต้องคิดโครงเอกสารเอง OpenSpec ให้โครงมาพร้อมแล้ว ไฟล์ proposal.md กับ specs/ ใช้แทน Ticket ที่เขียนเกณฑ์ตรวจรับไว้ได้ และ tasks.md ทำให้แผนแตกเป็นงานที่ตรวจทีละข้อได้
สิ่งที่ OpenSpec ไม่ได้ทำแทนคือ Tests, Review และ Approval Gate ซึ่งทีมต้องตั้งเอง /opsx:verify เทียบโค้ดกับ Spec ที่ตกลงกันไว้ ถ้า Spec เข้าใจผิดตั้งแต่แรก เช่น เข้าใจว่าผู้ใช้ที่ Login แล้วดาวน์โหลดใบแจ้งหนี้ใดก็ได้ ผลตรวจก็ผ่านได้เหมือนกัน จึงต้องอ่าน Spec ให้ละเอียดก่อนเริ่ม Apply เช่นเดียวกับที่ต้อง Review Test Cases
ถ้าทีมยังไม่มี Tests ควรเริ่มอย่างไร?
ทีมที่ยังตรวจงานด้วยมือเริ่มจากเขียนขั้นตอนตรวจรับให้ทำซ้ำได้ก่อน เช่น เตรียมบัญชีทดสอบสองบัญชี แต่ละบัญชีมีใบแจ้งหนี้ของตัวเอง แล้วตรวจทั้งการดาวน์โหลดตามปกติและการข้ามไปเรียกเอกสารของอีกบัญชี
เมื่อได้ขั้นตอนที่ชัดเจนแล้ว ค่อยเลือกกรณีสำคัญมาทำ Automated Tests เพิ่ม โดยเริ่มจากพฤติกรรมที่หากผิดแล้วกระทบข้อมูลหรือผู้ใช้มาก
เรื่องเครื่องมือ แต่ละภาษามีตัวเริ่มต้นที่พอสำหรับกรณีในบทความนี้ ไม่ต้องหาไลบรารีเพิ่มเยอะ:
เริ่มด้วย pytest ทดสอบ Endpoint ด้วย TestClient ของ FastAPI หรือ Test Client ของ Django
เขียนด้วยฟังก์ชันกับ assert ธรรมดา ไม่ต้องสร้าง Class แบบ unittest
เริ่มด้วย Vitest หรือ node:test (มีใน Node.js อยู่แล้ว) ทดสอบ Endpoint ด้วย supertest
ถ้าโปรเจกต์ใช้ TypeScript ผมเลือก Vitest ส่วน node:test เหมาะกับโปรเจกต์เล็กที่ไม่อยากเพิ่ม Dependency ถ้าโปรเจกต์ NestJS เดิมใช้ Jest อยู่แล้วก็ใช้ต่อได้ ไม่ต้องย้าย Test Runner ที่แปลง TypeScript ทีละไฟล์มักไม่ตรวจ Type ให้ จึงต้องรัน tsc --noEmit แยกอีกขั้น
เริ่มด้วยแพ็กเกจ testing กับ go test (มีในตัวภาษา) ทดสอบ Endpoint ด้วย net/http/httptest
ไม่ต้องติดตั้งอะไรเพิ่ม รัน go test ./... ได้ทันที และใส่ -race เพื่อตรวจ Data Race ได้ ถ้าอยากได้ Assertion ที่อ่านง่ายขึ้นค่อยเพิ่ม testify
กรณีแรกที่ควรเขียนคือกรณีเปลี่ยน ID ไปเรียกใบแจ้งหนี้ของบัญชีอื่น ให้ใช้เครื่องมือทดสอบ Endpoint ของภาษาที่ทีมใช้ ยิง Request เข้า Endpoint จริง เพราะกรณีนี้ต้องผ่านทั้ง Middleware ตรวจสิทธิ์และ Logic ดึงเอกสาร
ระหว่างที่ Tests ยังไม่พอ งานควรมีขนาดเล็กและตรวจได้ทั่วถึง ถ้าให้ AI แก้หลายส่วนพร้อมกัน จะระบุยากว่าความผิดปกติมาจากจุดไหน และคนที่ตรวจด้วยมือก็ต้องทำงานหนักขึ้น
จะรู้ได้อย่างไรว่า Workflow ใหม่ช่วยจริง?
ลองกับงานขนาดเล็กก่อน แล้วเก็บข้อมูลตั้งแต่เริ่มรับงานจน Deploy เสร็จ เช่น:
- ใช้เวลาชี้แจง Requirements เท่าไร?
- ต้องกลับมาแก้ความเข้าใจเรื่องโจทย์กี่ครั้ง?
- PR รอ Review นานเท่าไร?
- หลัง Review ต้องแก้งานมากแค่ไหน?
- มีปัญหาที่หลุดไปพบหลัง Deploy หรือไม่?
ถ้า Code เสร็จเร็วขึ้น แต่ต้องกลับมาแก้เรื่องสิทธิ์ซ้ำหลายรอบ แปลว่าควรปรับรายละเอียดโจทย์และกรณีทดสอบ ถ้า PR รอหลายวัน ให้ดูขนาดงานและกำลังของทีม Review
ข้อมูลจากงานจริงช่วยให้เลือกปรับได้ตรงจุดกว่าการวัดแค่จำนวน Code หรือจำนวน PR ที่สร้างได้
ถ้าทีมกำลังเริ่ม ผมจะเลือกหนึ่งฟีเจอร์ที่ขอบเขตชัด มีคนตรวจงาน แล้วลองใช้กระบวนการนี้ให้ครบ จากนั้นนำปัญหาที่เจอกลับมาแก้แนวทางของทีม ก่อนขยายไปสู่งานที่ซับซ้อนขึ้น
อ้างอิง
- Anthropic: The AI-native SDLC playbook
- OpenSpec: openspec.dev