
ทุกวันนี้ทุกคนถาม AI หรือ Search Google มากกว่ากันครับ?
วิธีการวัดว่า AI นำเว็บไซต์ของเราไปแนะนำลูกค้ามากแค่ไหนด้วยการตรวจ AEO ของเว็บไซต์
ทุกวันนี้ผมเชื่อว่าหลาย ๆ คนเลือกที่จะ "ASK AI" มากกว่า Search Google ด้วยตัวเองแล้ว หรือโดน Google AI Overviews แย่งการตอบคำถามไปแล้ว แล้วตอนนี้เว็บไซต์ที่เรากำลังดูแล (SEO) อยู่ มีการตอบสนองต่อ AEO ได้ดีแค่ไหนกัน?
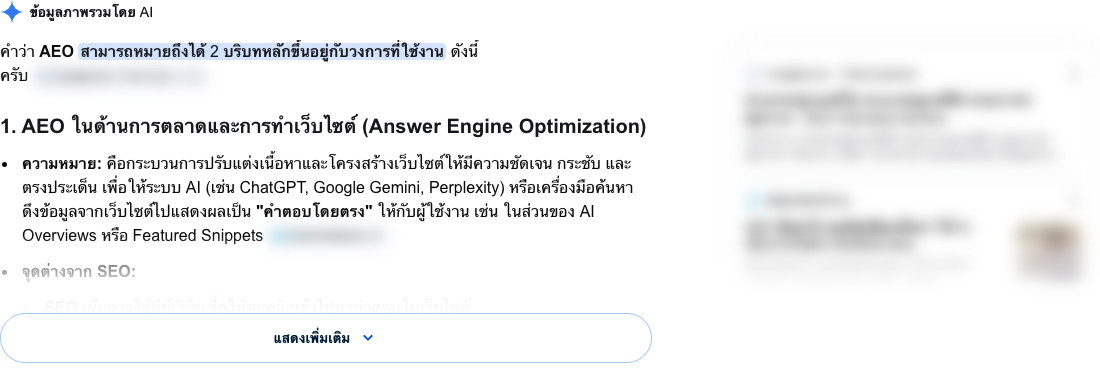
ตัวอย่าง AI Overviews ตอนค้นคำว่า "aeo คืออะไร" คำตอบมาก่อน ลิงก์เว็บอยู่ข้าง ๆ (เบลอชื่อเว็บออก)
AEO (Answer Engine Optimization) ในที่นี้คือการทำให้ AI หยิบเว็บเราไปตอบหรือแปะเป็นแหล่งอ้างอิง ใครยังไม่คุ้นคำนี้ ผมเขียนเทียบกับ SEO และ GEO ไว้ใน SEO vs AEO vs GEO ครับ
วันนี้ผมจะมาแชร์เทคนิคที่ผมใช้ในการวัดว่า AI แนะนำ branding ของเรามากแค่ไหน โดยยกตัวอย่างจาก AI ที่คิดว่าหลาย ๆ คนใช้กัน ได้แก่ GPT, Gemini, Perplexity, Claude และ DeepSeek ในการทดสอบผมใช้คำถาม 10 ข้อ ถามทุกเจ้า และถามซ้ำข้อละ 2 รอบ รวมได้ 100 คำตอบ โดยทุกเจ้าผมเปิด Web Search เอาไว้ด้วยนะครับ จะได้วัด AEO จริง ๆ ไม่ใช่วัดความรู้ที่อยู่ใน LLM อย่างเดียว
ที่ต้องเปิด Web Search เพราะถ้าไม่เปิด AI จะตอบจากความรู้ที่อยู่ในตัวโมเดลอย่างเดียว ซึ่งก็คือข้อมูลที่มันเคยเรียนมาตอนเทรน หยุดอยู่แค่วันที่เทรนเสร็จ เว็บเล็ก ๆ อย่างของผมแทบไม่มีทางไปอยู่ในนั้น (บทความที่เพิ่งเขียนอาทิตย์ก่อน ยิ่งไม่มีทาง) ถามไปก็ได้คำตอบว่าไม่รู้จัก หรือไม่ก็แต่งขึ้นมาเอง
พอเปิด Web Search โมเดลจะไปค้นเว็บก่อนตอบ แล้วเลือกอ่านผลการค้นหาสัก 3–4 หน้ามาเขียนคำตอบ พร้อมแปะลิงก์ที่ใช้มาให้ด้วย ตรงนี้แหละที่เว็บเรามีสิทธิ์โผล่ และเป็นสิ่งที่ AEO สนใจ คือเวลา AI ค้นเจอเรากับเว็บอื่นอีกเป็นสิบ มันเลือกหยิบเราไปตอบหรือเปล่า
แล้ว AI พูดถึง iamthana.com บ้างไหม?
จาก 100 คำตอบ มีที่เอ่ยชื่อ iamthana อยู่ 4 คำตอบ และมีที่แปะลิงก์กลับมาที่เว็บ 7 คำตอบ GPT กับ Perplexity ไม่พูดถึงเราเลยสักครั้ง
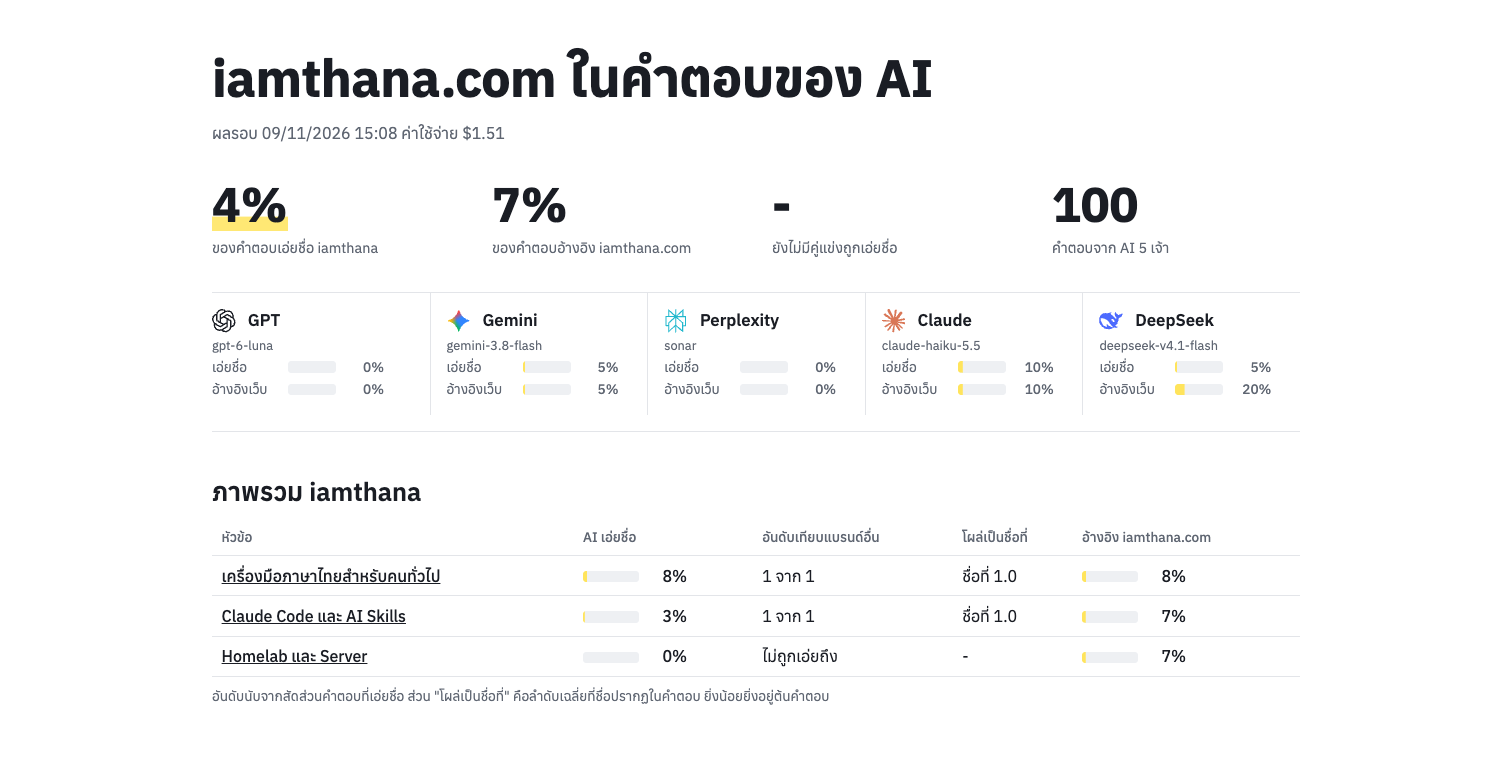
หน้ารายงานที่สคริปต์สร้างให้ แถวบนคือภาพรวมกับตัวเลขแยกตาม AI แต่ละเจ้า ตารางล่างแยกตามหัวข้อ
คำถาม 10 ข้อผมดึงมาจาก Google Search Console คือเอาคำที่คนค้นแล้วเจอเว็บผมจริง ๆ มาแปลงเป็นประโยคคำถามแบบที่คนพิมพ์ถาม AI เช่น คำค้น "สร้างรหัสผ่านแบบสุ่ม" กลายเป็น "เว็บสุ่มรหัสผ่านที่ปลอดภัย แนะนำหน่อย" แบ่งเป็น 3 กลุ่มตามเนื้อหาที่มีในเว็บ
| หัวข้อ | คำตอบ | เอ่ยชื่อ | แปะลิงก์ |
|---|---|---|---|
| เครื่องมือภาษาไทย (BAHTTEXT, เช็คเลขบัตรประชาชน, QR Code, สุ่มรหัสผ่าน) | 40 | 3 | 3 |
| Claude Code และ AI Skills | 30 | 1 | 2 |
| Homelab และ Server | 30 | 0 | 2 |
เครื่องมือภาษาไทย
- เว็บแปลงตัวเลขเป็นตัวหนังสือภาษาไทย บาทถ้วน ใช้ฟรี มีเว็บไหนบ้าง
- ตรวจเลขบัตรประชาชน 13 หลักว่าถูกต้องไหม ทำออนไลน์ได้ที่ไหน
- สร้าง QR Code ฟรี ไม่หมดอายุ เว็บไหนดี
- เว็บสุ่มรหัสผ่านที่ปลอดภัย แนะนำหน่อย
Claude Code และ AI Skills
- humanizer skill สำหรับ Claude Code คืออะไร ใช้ยังไง
- โหลด Agent Skills จาก GitHub มาใช้กับ Claude Code ต้องระวังอะไรบ้าง
- AI-native SDLC คืออะไร
Homelab และ Server
- sshole คืออะไร
- ตั้งค่า node_exporter ให้ปลอดภัยด้วย mTLS กับ basic auth ทำยังไง
- DinD กับ DooD ต่างกันยังไง ตอน build image ใน CI ควรเลือกแบบไหน
ที่แยก "เอ่ยชื่อ" กับ "แปะลิงก์" ออกจากกัน เพราะมันเกิดไม่พร้อมกัน อย่างคำถาม AI-native SDLC DeepSeek แปะลิงก์บทความผมทั้งสองรอบ แต่มีรอบเดียวที่พิมพ์ชื่อ iamthana ในคำตอบ อีกรอบเป็นแค่ลิงก์ท้ายข้อความ ถ้านับรวมกันจะมองไม่เห็นว่าอันไหนคือ AI รู้จักเรา อันไหนคือแค่เสิร์ชเจอ
คำตอบที่ดีที่สุดของรอบนี้มาจาก Claude ตอนถามหาเว็บแปลงตัวเลขเป็นตัวหนังสือ มันยกเว็บผมเป็นข้อ 4 ทั้งสองรอบ แล้วอธิบายถูกหมด ว่ารับเลขไทยและอารบิก ใส่ลูกน้ำได้ เติมคำว่า "ถ้วน" ให้ รับได้ถึง 999,999,999,999,999,999.99 บาท คืออ่านหน้าเว็บจริงแล้วเอามาสรุป
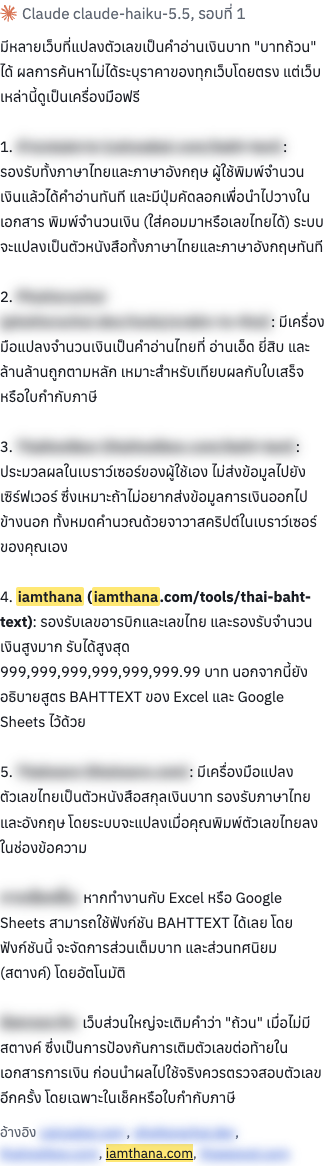
คำตอบเต็มของ Claude ในรายงาน ชื่อเราถูกไฮไลต์สีเหลือง (เบลอชื่อเว็บอื่นออก)
ส่วนที่แพ้ชัดคือเครื่องมือภาษาไทยที่เหลือ เว็บรวมเครื่องมือเจ้าหนึ่งโผล่ในคำตอบเรื่องเช็คเลขบัตรประชาชนครบทั้ง 10 คำตอบ ของผม Gemini เอ่ยถึงครั้งเดียว และพ่วงมาในวงเล็บหลังชื่อเขา
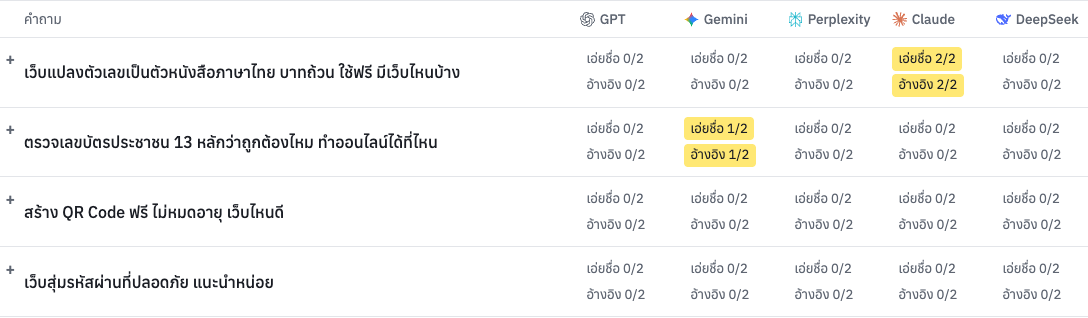
หัวข้อเครื่องมือภาษาไทยแยกรายคำถาม ช่องสีเหลืองคือที่เราโผล่ ที่เหลือคือ 0 ทั้งหมด
อีกอย่างที่เห็นคือ AI แต่ละเจ้ามองเว็บเล็กไม่เหมือนกัน ทั้งที่เปิดค้นเว็บเหมือนกันหมด DeepSeek แปะลิงก์เรา 4 จาก 20 คำตอบ มากสุดในกลุ่ม Claude 2 Gemini 1 ส่วน GPT กับ Perplexity ศูนย์ทั้งคู่ ถ้าวัดแค่เจ้าเดียวแล้วสรุป ก็จะได้ภาพคนละภาพกันเลย
แล้ว AEO วัดจากอะไร?
มันไม่มีวิธีการที่ตายตัวครับ แต่จากที่ลองอ่านมา ทั้งจาก Semrush, Ahrefs Brand Radar และ Nightwatch สรุปได้ดังนี้
- Mentions จำนวนคำตอบที่มีชื่อแบรนด์เราอยู่ (Semrush นับเป็นจำนวน prompt ที่เราโผล่ Nightwatch คิดเป็น % เรียก mention rate)
- Citations จำนวนคำตอบที่แปะลิงก์โดเมนเราเป็นแหล่งอ้างอิง Semrush แยกต่ออีกว่าหน้าไหนของเราถูกอ้าง (cited pages)
- Share of voice สัดส่วน mention ของเราเทียบกับคู่แข่งที่เราเลือกติดตาม ตัวเลขนี้เปลี่ยนตามว่าเราใส่ใครเป็นคู่แข่ง
- Position ชื่อเราโผล่ตรงไหนของคำตอบ ต้นหรือท้าย
- Sentiment AI พูดถึงเราในแง่ไหน
ที่ผมวัดรอบนี้คือสองตัวแรกเป็นหลัก เพราะนับได้จากคำตอบดิบตรง ๆ ส่วน share of voice ต้องมีรายชื่อคู่แข่งก่อน ซึ่งรอบแรกผมยังไม่รู้ว่าใคร เลยใช้วิธีดูจากโดเมนที่ AI อ้างแทน
มีข้อระวังอันหนึ่งที่สำคัญครับ SparkToro ทดลองถามคำถามเดิมซ้ำ ๆ พบว่าโอกาสที่ AI จะตอบรายชื่อแบรนด์ชุดเดิมมีไม่ถึง 1 ใน 100 และถ้านับลำดับด้วยก็ต่ำกว่า 0.1% Rand Fishkin ถึงกับบอกว่าเครื่องมือไหนขาย "อันดับใน AI" ให้ไม่ต้องเชื่อ สิ่งที่พอเชื่อได้คือ % การปรากฏเมื่อถามหลาย ๆ คำถามรวมกัน นี่คือเหตุผลที่ผมถามซ้ำทุกข้อ 2 รอบ และไม่ได้เอาลำดับมาเป็นตัวเลขหลัก (Supermetrics แนะนำให้ถามซ้ำ 3–5 รอบต่อเจ้าด้วยซ้ำ รอบนี้ผมทำแค่ 2)
ส่วน Google เองบอกไว้ใน Search Central ว่า AI Overviews กับ AI Mode ใช้ SEO แบบเดิมได้ ไม่ต้องทำอะไรพิเศษ แต่นั่นคือฝั่ง Google ChatGPT, Perplexity หรือ Claude เลือกแหล่งด้วยวิธีของใครของมัน เลยต้องวัดเอง
วัดยังไง
หลักการไม่มีอะไรซับซ้อนครับ เอาคำถามชุดเดียวกันไปถาม AI ทุกเจ้าผ่าน API เก็บคำตอบดิบกับลิงก์อ้างอิงที่มันส่งกลับมาไว้ทั้งหมด แล้วค่อยมานับทีหลังว่าคำตอบไหนมีชื่อเรา คำตอบไหนมีลิงก์เรา
ตัวโค้ดเขียนไม่นาน ที่ต้องคิดให้ดีคือ 4 ข้อนี้
คำถามต้องไม่มีชื่อเรา ถ้าพิมพ์ว่า "iamthana มีเครื่องมืออะไรบ้าง" AI ก็ไปค้นชื่อเราแล้วตอบตามนั้น ได้ 100% แน่นอนแต่ไม่มีความหมาย คำถามต้องเป็นแบบที่คนไม่รู้จักเราพิมพ์ ซึ่งแหล่งที่ดีที่สุดคือ Search Console เพราะเป็นคำที่คนค้นจริงแล้วเจอเรา
บังคับค้นเว็บ และเช็กว่าค้นจริง API ของแต่ละเจ้ามีวิธีเปิด Web Search ไม่เหมือนกัน และบางโมเดลรับคำสั่งไปแล้วแต่ไม่ได้ค้นจริง ตอบจากความจำเหมือนเดิม วิธีเช็กคือดูว่าคำตอบมี citation กลับมาไหม ถ้าโมเดลไหนได้ศูนย์ทั้งรอบ แปลว่าไม่ได้ค้น ต้องกลับไปแก้การตั้งค่า
แยกเอ่ยชื่อกับแปะลิงก์ อย่างที่เล่าไปข้างบน สองอย่างนี้เกิดไม่พร้อมกัน และบอกคนละเรื่อง
เก็บคำตอบดิบไว้ แล้วนับแยกต่างหาก ถ้าแก้ชื่อหรือ alias ทีหลัง ก็สั่งนับใหม่จากไฟล์เดิมได้ ไม่ต้องยิง API ซ้ำ และที่สำคัญกว่าคือได้กลับไปอ่านคำตอบเต็ม ๆ ว่า AI พูดถึงเรายังไง ซึ่งตัวเลขบอกไม่ได้
นอกจาก 4 ข้อนี้ ยังปรับต่อได้อีกอย่างคือใส่คู่แข่งเข้าไปด้วย รอบนี้ผมใส่แค่แบรนด์ตัวเอง รายงานเลยบอกได้แค่ว่าเราโผล่หรือไม่โผล่ ถ้าเพิ่มชื่อคู่แข่งกับ alias ของเขาลงใน config ตัวนับเดียวกันจะบอกได้ทันทีว่าในหัวข้อนี้ AI เอ่ยถึงใครบ่อยกว่า เราอยู่อันดับที่เท่าไร และชื่อใครโผล่ก่อน ซึ่งก็คือ share of voice ที่เครื่องมือพวก Semrush ขายนั่นแหละ สำหรับเว็บบริษัทที่มีคู่แข่งชัด ตรงนี้มีประโยชน์กว่า % ของตัวเองลอย ๆ เพราะบอกว่าเราแพ้ใคร
ส่วนจะรู้ได้ยังไงว่าใครคือคู่แข่ง รอบแรกไม่ต้องเดา ดูจากโดเมนที่ AI อ้างในคำตอบที่ไม่มีเรา แล้วค่อยเอาชื่อพวกนั้นใส่ในรอบถัดไป (รอบนี้ของผมก็เห็นแล้วว่าเว็บรวมเครื่องมือเจ้าหนึ่งครองหัวข้อเครื่องมือไทยอยู่)
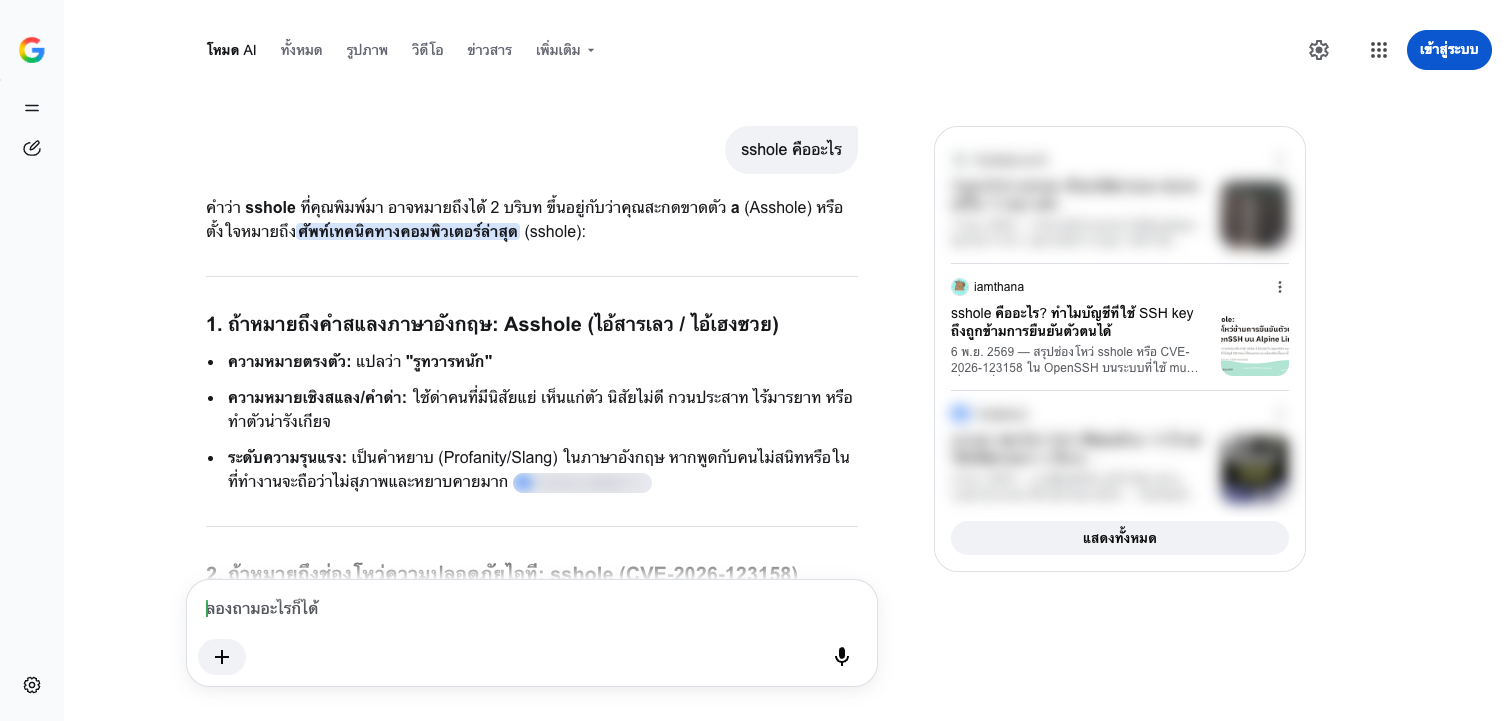
ตัวอย่างการพิมพ์ถามเองใน Google AI Mode แบบไม่ล็อกอิน คำถาม "sshole คืออะไร" ได้บทความของผมเป็นแหล่งอ้างอิงอันที่ 2 (เบลอแหล่งอื่นออก) ส่วน Google AI Mode กับ Copilot วัดผ่าน API ไม่ได้ ถ้าอยากรู้ต้องลองถามเองแบบนี้
รอบนี้ 100 คำตอบใช้ไปประมาณ $1.5 ครับ
อยากลองกับเว็บตัวเอง
ก่อนอื่นต้องมี API ของ AI ที่จะทดสอบ ทำได้ 2 ทาง ทางแรกคือสมัคร API แยกทีละเจ้า OpenAI, Google, Anthropic, Perplexity, DeepSeek ได้ราคาตรงจากผู้ให้บริการ แต่ต้องจัดการ 5 บัญชี 5 key และโค้ดต้องรองรับ API คนละหน้าตา ทางที่สองคือใช้ตัวกลางอย่าง OpenRouter key เดียวเรียกได้ทุกเจ้าผ่าน API หน้าตาเดียวกัน แลกกับค่าธรรมเนียมตอนเติม credit (ตอนนี้ 5.5% ของยอดเติม ไม่ได้บวกเพิ่มที่ราคาต่อ token)
สำหรับงานแบบนี้ผมแนะนำทางที่สองครับ เพราะเราต้องการเทียบหลายเจ้าพร้อมกันในรอบเดียว (ไม่ได้ sponsor นะ ผมใช้เองมาปีกว่าแล้ว) ส่วนใครที่มี API ของแต่ละเจ้าอยู่แล้วก็ใช้ของเดิมได้ แค่ปรับ prompt ด้านล่างให้ agent ต่อ API ตรงแทน
ผมไม่ได้แจกโค้ด เพราะตัวโค้ดไม่ใช่ส่วนที่ยาก ที่ยากคือเงื่อนไข 4 ข้อข้างบนกับกับดักเล็ก ๆ ที่ต้องเจอเองตอนต่อ API ผมเลยเอาทั้งหมดนั้นเขียนเป็น prompt ไว้ให้ เอาไปวางใน Claude Code หรือ AI coding agent ตัวไหนก็ได้
Build a small Python CLI, standard library only, that measures how often AI
answer engines name my brand and cite my website. Before writing any code,
ask me for: my domain, my brand name and its aliases, the prompts to test
grouped by topic, and how many times to repeat each prompt.

Put all of that in config.json together with the list of OpenRouter model
slugs and an optional list of competitor brands with their aliases, so I can
change the site or the prompts without touching code. Prompts must never
contain my brand name or a competitor's. Use this shape:

{
  "site": "example.com",
  "own_brand": "Example",
  "brands": {
    "Example": ["example", "example.com"],
    "Competitor A": ["competitor a", "competitora"]
  },
  "models": {
    "openai/gpt-6-luna": {"search": "exa"},
    "google/gemini-3.8-flash": {"search": "exa"},
    "perplexity/sonar": {}
  },
  "runs": 2,
  "concurrency": 8,
  "topics": {
    "Topic name": {
      "brands": ["Competitor A"],
      "prompts": ["first question as a real person types it", "second question"]
    }
  }
}

A topic that lists competitors measures whether I get named next to them; a
topic with no competitors measures whether my pages get cited. A model that
searches on its own, such as Perplexity, gets `{}` instead of an engine.

Calls go through the OpenRouter chat completions API, key read from .env.
Every call must search the web before answering: use the
`openrouter:web_search` server tool with `tool_choice: "required"` and let me
pin the search engine per model in config. Do not use the deprecated `:online`
suffix or the `plugins: [{id: "web"}]` option. Some models accept the tool
and still do not search, so record whether each response carried any
`url_citation` annotations and warn about any model with zero citations
across the run.

Save every raw answer to runs/<timestamp>.json as a list of rows, one per
call, exactly like this so other tools can read it:

{"topic": "Topic name", "prompt": "...", "model": "openai/gpt-6-luna",
 "cost": 0.0078, "answer": "full answer text", "citations": ["https://..."]}

and for a failed call:

{"topic": "Topic name", "prompt": "...", "model": "...", "error": "HTTP 429: ..."}

Run calls in parallel with configurable concurrency, retry 429 and 5xx
with backoff, and never let one bad response lose the whole paid run.

Scoring is a separate command that re-reads a saved run, so I can change
aliases without paying again. Count two things independently per answer:
"mentioned" when an alias appears in the answer text, "cited" when a citation
URL is on my domain (strip www, exact match). Alias matching is
case-insensitive and may not touch an ASCII letter or digit on either side,
but must still match when Thai characters touch the alias: Thai has no spaces
and Python's \b treats Thai letters as word characters. Apply the same
matching to competitor brands, so each topic can show how often every brand
is named and where mine ranks.

Render runs/<timestamp>.html: overall mention and citation share, total
cost, one card per model, a per-topic table with the brand ranking, and under
each prompt the full answers with my brand highlighted. Treat answers and URLs as untrusted:
escape everything, keep only http(s) links, add a CSP that allows no scripts.

Add a `plan` command that prints the call count and a cost estimate from
previous runs before I spend anything.

Write tests for the two parts that fail silently: alias matching (including
an alias touching Thai characters, and an alias that is a substring of
another word) and HTML rendering with injection payloads in the answer text
and URLs.
prompt ยาวหน่อย เพราะแต่ละย่อหน้ากันปัญหาคนละเรื่อง ไล่ให้ฟังว่าทำไมต้องมี
Before writing any code, ask me for: my domain, my brand name and its aliases, the prompts to test grouped by topic, and how many times to repeat each prompt.
ให้ agent ถามก่อน จะได้วาง prompt นี้ได้ทันทีโดยไม่ต้องแก้อะไรข้างใน แล้วทั้งหมดนั้นไปอยู่ใน config.json แยกจากโค้ด เปลี่ยนเว็บที่วัดหรือเพิ่มคำถามได้โดยไม่ต้องแตะโค้ด ที่แปะหน้าตา JSON ไว้ให้ทั้ง config และไฟล์ผลลัพธ์ เพราะถ้าปล่อยให้ agent ออกแบบเอง แต่ละรอบจะได้โครงไม่เหมือนกัน พอจะเอาไฟล์ผลไปเทียบข้ามรอบหรือเขียนสคริปต์อ่านต่อ จะเจอ field คนละชื่อ ส่วน Prompts must never contain my brand name. คือกฎข้อแรกของเรื่องนี้ ใส่ชื่อเราในคำถามเมื่อไร ตัวเลขก็ไม่มีความหมาย
Every call must search the web before answering: use the
openrouter:web_searchserver tool withtool_choice: "required"... Do not use the deprecated:onlinesuffix or theplugins: [{id: "web"}]option.
กับดักที่ผมเสียเวลามากที่สุด OpenRouter มีวิธีเปิดค้นเว็บหลายแบบ แบบเก่ายังใช้ได้แต่ถูก deprecate แล้ว เลยล็อกให้ใช้ server tool ตัวใหม่ไปเลย ส่วนท่อนถัดมาสำคัญกว่า
Some models accept the tool and still do not search, so record whether each response carried any
url_citationannotations and warn about any model with zero citations across the run.
บางโมเดลรับคำสั่งค้นเว็บไปแล้วไม่ได้ค้นจริง ถ้าไม่เช็กว่ามี citation กลับมาไหม จะได้ตัวเลขที่ดูเหมือนวัด AEO แต่จริง ๆ วัดความจำของโมเดล
Run calls in parallel with configurable concurrency, retry 429 and 5xx with backoff, and never let one bad response lose the whole paid run.
เก็บทุกอย่างดิบ ๆ ลงไฟล์ รวมถึง call ที่พัง (แถว error ในตัวอย่าง JSON ข้างบน) และห้ามให้ response เสียอันเดียวทำให้ทั้งรอบที่จ่ายเงินไปแล้วหายหมด
Scoring is a separate command that re-reads a saved run, so I can change aliases without paying again.
การนับแยกจากการยิง API จะได้นับใหม่ได้ฟรี และย่อหน้าเดียวกันมีท่อนที่เขียนยาวเป็นพิเศษ
Alias matching ... must still match when Thai characters touch the alias: Thai has no spaces and Python's \b treats Thai letters as word characters.
ถ้าไม่บอก agent จะเขียน \b มาให้แน่นอน แล้วคำตอบภาษาไทยที่เขียนติดกันแบบ "ลองHubSpotดู" (ซึ่ง AI ชอบทำ) จะหาชื่อแบรนด์ไม่เจอ ตัวจับเดียวกันนี้ใช้กับชื่อคู่แข่งด้วย ตารางต่อหัวข้อเลยบอกอันดับเราเทียบกับเขาได้
Treat answers and URLs as untrusted: escape everything, keep only http(s) links, add a CSP that allows no scripts.
<script> หรือลิงก์ javascript: ไว้ แล้ว AI ลอกมาตรง ๆ รายงานของเราก็จะรันโค้ดนั้นตอนเปิดดู นี่คือ XSS ที่เกิดจากข้อมูลที่เราไปเก็บมาเอง ทุกค่าที่ลง HTML ต้อง escape ทั้งเนื้อหาและ attribute ลิงก์รับเฉพาะ http(s) และใส่ CSP ที่ไม่อนุญาต script เลย เพื่อให้ต่อให้พลาดชั้นแรก ชั้นสองก็ยังกันอยู่Add a
plancommand that prints the call count and a cost estimate from previous runs before I spend anything.
มีไว้ดูจำนวน call กับค่าใช้จ่ายโดยประมาณก่อนกดรัน เพราะพอเพิ่มคำถามหรือโมเดล จำนวน call มันคูณกันขึ้นเร็วกว่าที่คิด
Write tests for the two parts that fail silently: alias matching ... and HTML rendering with injection payloads
สองจุดนี้ถ้าพังจะไม่มี error ให้เห็น regex ที่หาชื่อไม่เจอก็แค่ได้ 0% ส่วน HTML ที่ไม่ escape ก็แสดงผลปกติจนกว่าจะเจอคำตอบที่มีโค้ดแปลก ๆ ติดมา เลยให้ agent เขียน test ไว้ตั้งแต่แรก และสั่งให้มันรัน test ก่อนส่งงาน
สิ่งที่ต้องเตรียมเองคือ API key กับรายการคำถามจาก Search Console ของเว็บคุณ ที่เหลือให้ agent ทำ
ส่วนหน้ารายงาน prompt ข้างบนบอกแค่ว่าต้องมีอะไรบ้าง agent จะออกแบบหน้าตาเอง ถ้าอยากได้แบบเดียวกับในรูปของผม ส่ง prompt นี้ต่อท้ายไปอีกอัน
Render the HTML report as a single self-contained page, Thai UI text, no
JavaScript, with a Content-Security-Policy that allows no scripts. Use a
Thai-capable sans-serif font stack and support dark mode through
prefers-color-scheme. Keep the page quiet: thin hairline rules, lots of
whitespace, one accent colour (a yellow marker) used only for my brand.

Layout, top to bottom:

1. Masthead: h1 "<site> ในคำตอบของ AI", a line with the run date and total
   cost, then four big stats side by side: % of answers naming my brand
   (this one gets the yellow marker underline), % citing my site, the most
   named competitor and its %, and the number of answers with the number of
   models. Below that, one card per model: provider logo and name, the model
   slug in small muted text, and two rows "เอ่ยชื่อ" and "อ้างอิงเว็บ", each a
   small horizontal bar plus a percentage.

2. Overview table "ภาพรวม <brand>": one row per topic linking to its
   section, columns: topic, % named (bar + %), rank among brands as
   "<rank> จาก <n>" or "ไม่ถูกเอ่ยถึง", average position as "ชื่อที่ <x.x>", and
   % cited (bar + %). A muted one-line hint explains rank and position.

3. One section per topic: h2 with the topic name, a muted line "<n> คำถาม
   <m> คำตอบ", then two tables side by side on wide screens: "แบรนด์ที่ AI
   เอ่ยถึง" (rows = brands, columns = one per model plus "รวม", cells = bar
   + %; my brand's row is tinted yellow with a thick left marker) and "เว็บที่
   AI ใช้อ้างอิง" (top 12 cited domains with bar + %, my domain tinted the
   same way).

4. Under each topic, "แยกตามคำถาม": a header row with the model logos, then
   one native <details> per prompt. The <summary> shows a "+" marker, the
   prompt text, and per model two small chips "เอ่ยชื่อ <hits>/<total>" and
   "อ้างอิง <hits>/<total>", tinted yellow when hits > 0. Inside, one
   <article> per answer with a heading "<logo> <Provider> <model slug>, รอบที่
   <n>", the full answer text with **bold** rendered, my brand wrapped in
   <mark> with the yellow marker and other configured brands in a grey
   <mark>, and a closing line "อ้างอิง <domain>, <domain>…" linking each cited
   domain once, my domain styled as the own link.

Bars are inline-block spans whose width is driven by a CSS custom property
(--share) so no script is needed.

Security is not optional here, because answer text and citation URLs come
from third-party web pages: HTML-escape every value in both text and
attributes (answers, prompts, brand names, model slugs, URLs, titles); turn
a URL into a link only if its scheme is http or https, otherwise print it
as text; give every link rel="noopener noreferrer"; never emit inline event
handlers; and send a CSP of `default-src 'none'; style-src 'unsafe-inline';
img-src 'self' data:` via a <meta http-equiv> tag. Keep the test from the
main prompt that renders injection payloads and fails if any tag, event
handler or non-http link survives.
เอาไปทำอะไรต่อ
ตัวเลข 4 จาก 100 ไม่ได้ทำให้ผมตกใจ เพราะพอเปิดคำตอบดูก็เห็นว่าแพ้ให้ใคร และแพ้เพราะอะไร
คำถามแบบ "เว็บไหนดี" ของเครื่องมือทั่วไป อย่าง QR Code หรือสุ่มรหัสผ่าน AI ตอบแบรนด์ใหญ่ที่คนรู้จักอยู่แล้วทั้งนั้น เว็บส่วนตัวจะไปแข่งชื่อกับแบรนด์ระดับโลกพวกนั้นก็คงไม่ไหว และไม่จำเป็นด้วย ส่วนคำถามเรื่อง Claude Code ลิงก์เกินครึ่งไปที่ GitHub ของตัว skill เอง บทความสอนภาษาไทยมีที่ยืนแค่ตอน AI อยากหา "ฉบับภาษาไทย" ซึ่ง DeepSeek ทำจริง ๆ กับบทความ AI-native SDLC ของผม
สิ่งที่ผมจะทำต่อจากรอบนี้
- หน้า BAHTTEXT ที่ Claude อธิบายได้ถูกทุกข้อ เพราะหน้านั้นเขียนความสามารถไว้ตรง ๆ (รับเลขไทย ใส่ลูกน้ำได้ เพดานเท่าไร) ผมจะกลับไปเขียนหน้าเครื่องมือตัวอื่นให้ชัดแบบเดียวกัน โดยเฉพาะหน้าเช็คเลขบัตรประชาชนที่ตอนนี้แพ้ 1 ต่อ 10
- เก็บคำถาม 10 ข้อนี้ไว้เป็นชุดมาตรฐาน ไม่แก้ แล้วรันซ้ำอีกทีเดือนหน้า ถ้าเปลี่ยนคำถามเมื่อไร ตัวเลขก็เทียบกันไม่ได้
- รอบหน้าถามซ้ำ 3 รอบแทน 2 ตามที่ SparkToro กับ Supermetrics แนะนำ และใส่ชื่อเว็บที่ AI อ้างแทนเราในรอบนี้เข้าไปเป็นคู่แข่ง
ข้อจำกัดที่ต้องรู้ก่อนเชื่อตัวเลข: แต่ละคำถามมีแค่ 10 คำตอบ ขยับ 1 คำตอบคือ 10% แล้ว การวัดผ่าน API ที่บังคับค้นเว็บไม่เหมือนหน้าแชทที่โมเดลเลือกเองว่าจะค้นไหม และ Google AI Overviews กับ Copilot วัดผ่านทางนี้ไม่ได้ ต้องดูจาก Search Console แยก
สรุป
AEO วัดได้ด้วยของที่มีอยู่แล้ว คือคำค้นจาก Search Console กับ API ของ AI ที่เราอยากรู้ ถามไป 100 คำตอบก็เห็นแล้วว่าหน้าไหนที่ AI อ่านแล้วเข้าใจ หน้าไหนที่ AI ยังไม่หยิบ และใครได้พื้นที่นั้นไป ถ้ามีเว็บที่ดูแลอยู่ ลองวันนี้เลยครับ
จะใช้วิธีไหนก็ได้ที่ถนัดนะครับ จะ copy prompt ข้างบนไปวาง หรือโยนบทความนี้ทั้งอันให้ AI อ่านแล้วให้มันสร้างให้ก็ได้ผลเหมือนกัน ส่วนใครไม่อยากทำเองเลย ทักมาได้ครับ แฮร่
References
คำถามที่พบบ่อย
ลองถามในหน้าแชทแทนการเรียก API ได้ไหม?
ได้ แต่ให้เปิด incognito หรือแชทชั่วคราวที่ไม่ล็อกอิน เพราะบัญชีประจำมี memory ที่อาจทำให้ AI แนะนำเว็บเราเพราะจำได้ ไม่ใช่เพราะค้นเจอ และหน้าแชทให้โมเดลเลือกเองว่าจะค้นเว็บหรือไม่ ผลจึงไม่เหมือนการเรียก API ที่บังคับค้นทุกครั้ง เหมาะกับลองดูคร่าว ๆ ไม่เหมาะกับการเก็บตัวเลขเทียบข้ามรอบ
วัด Google AI Overviews ได้ด้วยวิธีนี้ไหม?
ไม่ได้ Google AI Overviews กับ Microsoft Copilot ไม่มีให้เรียกผ่าน API แบบเดียวกัน ฝั่ง Google ให้ดูจาก Search Console แทน ซึ่ง Google บอกว่าการปรากฏใน AI Overviews และ AI Mode นับรวมอยู่ในรายงาน Performance ปกติ
ต้องวัดบ่อยแค่ไหน?
วัดซ้ำด้วยคำถามชุดเดิมหลังปรับเนื้อหาแต่ละครั้ง หรือเดือนละครั้งก็พอ สิ่งที่ห้ามทำคือเปลี่ยนคำถามระหว่างรอบ เพราะตัวเลขจะเทียบกันไม่ได้ และอย่าตีความการขยับ 1–2 คำตอบเป็นแนวโน้ม เพราะ AI ตอบไม่เหมือนเดิมทุกครั้งอยู่แล้ว
ทำไมไม่ใช้เครื่องมืออย่าง Semrush หรือ Ahrefs ไปเลย?
ใช้ได้ถ้ามีอยู่แล้ว เครื่องมือพวกนั้นวัดตัวเลขชุดเดียวกัน (mentions, citations, share of voice) และมีข้อมูลคู่แข่งให้พร้อม ข้อดีของการทำเองคือได้คำตอบดิบทั้งหมดมาอ่าน เลือกคำถามจากคำค้นจริงของเว็บเราเอง และเพิ่มโมเดลหรือคำถามได้ทันทีโดยไม่ติดแพ็กเกจ